Un site techniquement sain mais invisible sur Google souffre rarement d’un problème de contenu. Le diagnostic commence presque toujours par le crawl : si Googlebot ne parvient pas à explorer correctement les pages, aucune optimisation éditoriale ne produira d’effet mesurable. Avant de rédiger un mot, il faut s’assurer que l’infrastructure du site permet l’indexation, que les signaux envoyés aux moteurs sont cohérents et que le maillage interne distribue l’autorité là où elle compte.
Crawl budget et indexation : le socle technique que les guides SEO survolent
La majorité des sites de PME gaspillent leur crawl budget sur des pages sans valeur : filtres à facettes, paginations dupliquées, paramètres d’URL générés par le CMS. Chaque URL inutile explorée par Googlebot est une URL stratégique qui attendra le prochain passage du robot.
Lire également : Permanence téléphonique médicale, comment rassurer les patients en dehors des horaires du cabinet
Bloquer les chemins parasites dans le robots.txt ne suffit pas. Une directive Disallow empêche l’exploration, pas l’indexation. Si des liens internes pointent vers ces pages, Google peut les indexer sans les crawler, ce qui crée des entrées d’index fantômes. La combinaison robots.txt + balise meta noindex sur la page elle-même reste la méthode fiable pour éliminer ces résidus.
Search Console signale les erreurs d’exploration dans le rapport « Pages ». Filtrer par « Explorée, non indexée actuellement » révèle souvent des centaines de pages que Google juge trop faibles pour mériter une place dans l’index. Plutôt que de les améliorer une par une, regrouper ces contenus en pages consolidées réduit la dilution et concentre la pertinence thématique.
Le référencement naturel repose sur cette mécanique d’arbitrage : Google dispose d’un temps limité pour explorer chaque domaine, et c’est au propriétaire du site de guider ce temps vers les pages qui génèrent du trafic qualifié.
Trois vérifications techniques à mener avant toute autre action :
- Vérifier que le sitemap XML ne contient que des URL canoniques renvoyant un code 200, sans redirections ni pages bloquées par le robots.txt.
- Contrôler que chaque page stratégique possède une balise canonical pointant vers elle-même, pas vers une variante avec paramètre ou vers un ancien slug.
- S’assurer que le temps de réponse serveur (TTFB) reste sous la barre perceptible par Googlebot, ce qui se mesure directement dans le rapport « Statistiques sur l’exploration » de Search Console.
Maillage interne et profondeur de clic : redistribuer l’autorité SEO
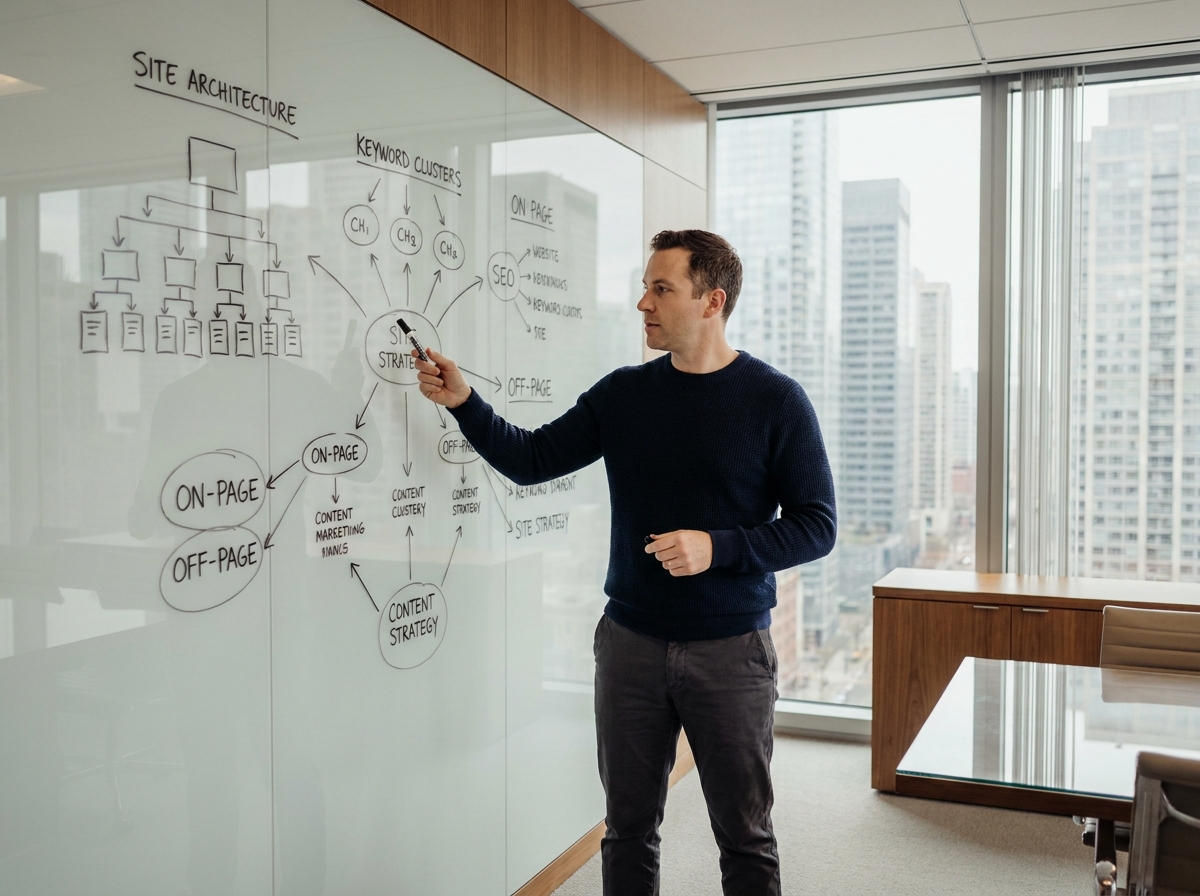
Un site peut publier du contenu de qualité et ne jamais ranker parce que ses pages profondes sont à quatre, cinq ou six clics de la page d’accueil. Chaque clic supplémentaire divise le PageRank transmis et réduit la fréquence de crawl de la page cible.
Le maillage interne n’est pas un exercice de décoration. Nous recommandons de cartographier les pages par cluster thématique, puis de vérifier que chaque page cible reçoit au minimum trois liens internes contextuels depuis des pages du même cluster. Un lien dans le corps du texte pèse davantage qu’un lien en pied de page ou dans un menu latéral.
Concrètement, une page pilier sur un sujet large (par exemple « isolation thermique ») doit pointer vers les pages spécifiques (isolation des combles, isolation par l’extérieur, matériaux biosourcés) et chaque page spécifique doit remonter vers la page pilier. Ce modèle hub-and-spoke est documenté et les ressources techniques publiées par tout blog high-tech spécialisé en SEO le confirment régulièrement.
L’erreur fréquente consiste à concentrer tous les liens internes sur la page d’accueil et les pages catégories, en laissant les articles de blog orphelins. Un article sans lien interne entrant est un article que Google découvre tard, explore rarement et positionne mal.
Ancres internes et signal thématique
L’ancre du lien interne transmet un signal sémantique au moteur. « Cliquez ici » ou « en savoir plus » ne communiquent rien. L’ancre doit contenir le mot-clé principal de la page cible ou une variante proche.
Varier les ancres internes évite la sur-optimisation tout en couvrant le champ lexical de la page de destination. Si la page cible traite des « fenêtres double vitrage », les ancres internes peuvent alterner entre « fenêtres double vitrage », « remplacement de double vitrage » et « performance thermique des vitrages ».
Contenu et données structurées : ce que Google attend réellement
Google n’a pas besoin de contenu long. Il a besoin de contenu qui répond à une requête mieux que les pages déjà positionnées. La longueur d’un texte n’est pas un facteur de classement en soi : c’est la couverture sémantique du sujet et la satisfaction de l’intention de recherche qui comptent.
Un piège courant est de produire des articles de blog sans cibler une requête identifiée. Avant de rédiger, vérifier dans Search Console les requêtes pour lesquelles le site apparaît déjà (rapport « Performances », filtre par page) permet de détecter des opportunités immédiates. Une page positionnée en bas de première page ou en haut de deuxième page peut souvent gagner plusieurs positions avec un enrichissement ciblé du contenu existant, sans créer de nouvelle URL.
Données structurées et visibilité dans les résultats enrichis
Les données structurées ne sont pas un facteur de classement direct, mais elles augmentent la surface d’affichage dans les résultats de recherche. Un balisage FAQ, HowTo ou Product correctement implémenté peut générer des extraits enrichis qui améliorent le taux de clic sans modifier la position organique.
Un point récent mérite attention : Google confirme qu’il n’existe pas de balisage structuré spécifique à ajouter pour apparaître dans les AI Overviews ou dans AI Mode. Les pages doivent être indexées et éligibles aux extraits classiques. Toute prestation qui promet un « marquage spécial IA » repose sur une information erronée.
La cohérence entre les données structurées et le contenu visible de la page est un critère de qualité documenté par Google. Un schéma Product qui affiche un prix différent de celui visible sur la page peut entraîner la suppression de l’extrait enrichi.
Stratégie de liens externes : qualité du domaine référent et pertinence thématique
Obtenir des liens entrants reste un levier puissant, mais la méthode a changé. Un lien depuis un site thématiquement proche vaut plus qu’un lien depuis un domaine à forte autorité hors sujet. Google évalue la pertinence contextuelle du lien, pas seulement la popularité du domaine source.
Les pratiques à éviter sont clairement définies par la politique antispam de Google : échanges de liens systématiques, achat de liens sur des annuaires de masse, articles invités publiés uniquement pour le backlink. La production massive de pages destinées à manipuler les classements est visée, qu’elle soit réalisée par des outils automatisés ou manuellement.
Prioriser les liens éditoriaux naturels
Un lien éditorial provient d’un site qui cite une ressource parce qu’elle apporte une valeur réelle à ses lecteurs. Pour en obtenir, le site doit publier un contenu qui mérite d’être référencé : une étude originale, un outil gratuit, une base de données, un comparatif technique détaillé.
Les pages « linkable assets » les plus efficaces sont celles qui répondent à une question récurrente du secteur avec des données que personne d’autre ne compile. Un tableau comparatif mis à jour régulièrement génère des liens naturels sur la durée, contrairement à un article d’opinion qui ne sera cité qu’une fois.
Suivi et interprétation des résultats SEO dans Search Console
Le rapport de performances de Search Console agrège les clics et impressions provenant des résultats classiques, des AI Overviews et d’AI Mode sous le type de recherche « Web ». Il n’existe pas de rapport distinct pour isoler le trafic généré par les fonctionnalités IA de Google.
Cette limitation impose une prudence dans l’interprétation. Une hausse d’impressions sans hausse de clics peut indiquer que la page apparaît dans un AI Overview sans générer de visite. Comparer les données sur des périodes glissantes de quatre semaines minimum donne une image plus fiable que l’analyse jour par jour.
Trois indicateurs à surveiller en priorité :
- Le taux de clic moyen par requête stratégique, qui révèle si les balises title et meta description attirent réellement le clic.
- Le nombre de pages indexées versus le nombre de pages soumises dans le sitemap, qui signale un écart entre ce que le site propose et ce que Google retient.
- La position moyenne pondérée par les impressions, plus représentative que la position brute sur des requêtes à faible volume.
Attribuer automatiquement une variation de trafic à une action SEO précise est une erreur fréquente. Les mises à jour d’algorithme, les changements de comportement saisonnier et l’évolution de la concurrence influencent les résultats en parallèle. Le suivi SEO sérieux croise les données Search Console avec les journaux serveur et les outils de suivi de positions pour confirmer une tendance avant de l’attribuer à une cause.
La visibilité organique se construit sur l’accumulation de signaux cohérents : un crawl maîtrisé, un maillage structuré, un contenu calibré sur l’intention de recherche et des liens pertinents. Aucun de ces leviers ne fonctionne isolément, et l’ordre dans lequel on les traite détermine la vitesse des résultats.